WorkBuddy2API Panel 部署教程:把 CodeBuddy 账号变成 OpenAI 兼容 API(多账号池 + Web 面板)
摘要
一个 Go 单文件自托管网关,把腾讯 CodeBuddy 账号包装成 /v1/chat/completions:多账号轮转、限流冷却与熔断、会话粘性、定时签到保活、成长任务一键完成 17/18,内嵌七视图 Web 管理面板。按 v1.12.0 源码与实测整理三条部署路线、账号池调度细节与配置坑。
腾讯 CodeBuddy 有 IDE 插件、CLI 和网页版,但官方没有给出一条 OpenAI 形态的开放接口。于是想让本地那些只认 base_url + api_key 的工具用上自己的账号,就得在中间自己架一层代理。
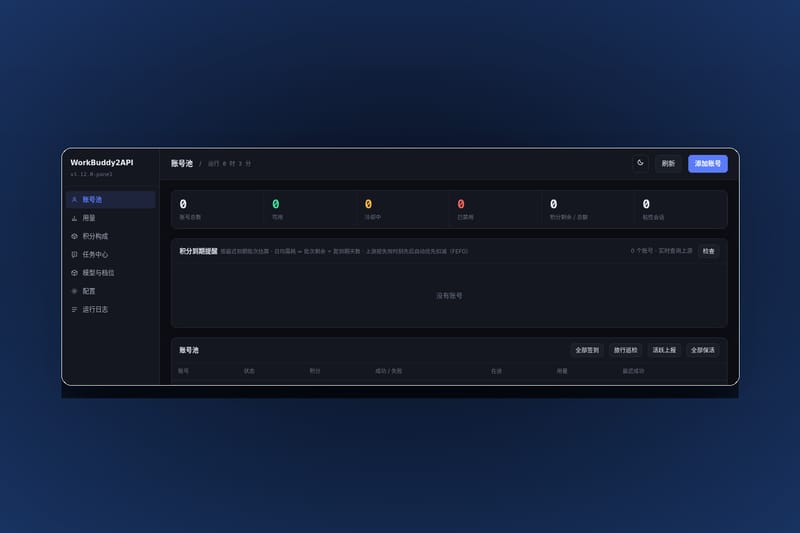
WorkBuddy2API Panel 干的就是这件事:一个 Go 写的单文件自托管网关,把 CodeBuddy 账号包装成 /v1/chat/completions,多个账号轮着用,某个号限流了就自动冷却换人,还内嵌了一个七视图的 Web 管理面板。
它源自 Sliverkiss/workbuddy2api(上游仓库现已删除),本分支在吸收上游删库前最后一次更新后独立演进,把可视化运维层几乎重做了一遍。仓库当前 release 是 v1.12.0(2026-10-05 发布,MIT 协议),五平台二进制 + GHCR 镜像齐全。
本文按 v1.12.0 的源码与 Release 产物整理,并在 NAS 上真跑了一个实例,把面板界面、账号池调度逻辑和配置里的几个坑一并记下来。
它解决什么问题
CodeBuddy 的账号体系里,积分(credits)是消耗品:模型调用按积分计费,任务中心会定期发放签到积分和成长任务奖励。单人单账号用,问题不大;一旦把账号接进 Open WebUI、Cherry Studio、Dify、New API 这类客户端,就会立刻遇到三个现实问题:
单账号容易被限流,429 一来整条链路就断,客户端只会给你报错;
积分消耗快,签到、保活、任务中心那些白拿的积分没人记得每天去领;
没有可观测性,谁在消耗、消耗在哪个模型上、当前还剩多少,全靠猜。
这个项目的解法是把它做成账号池网关:请求进来先选号(优先快过期的积分、按成本分层加权随机),调用失败按错误类型分流冷却,会话层面做粘性绑定,空闲时间跑定时任务把该领的积分领了。面板则是把这些状态全部摊开给你看。
v1.12.0 有什么
OpenAI 兼容接口:
/v1/chat/completions、/v1/models、/v1/models/{model}、/healthz,支持流式与非流式;/v1/models返回的模型目录是上游 `/v3/config` 与企业端点两路并发探测后的并集,比官方客户端里看到的还多。多账号池:加权随机选号 + Top-5 候选防惊群、按错误分类的冷却与熔断、
conversation_id会话粘性(TTL 30 分钟)。任务自动化:签到、活跃上报、猫猫旅行、token 保活、夜猫子、成长任务,五类独立排程。
成长任务一键完成:18 个成长任务里能自动做完 17 个。
系统提示词体系:
custom/append/passthrough三种模式,外加指纹脱敏、内容拦截后的降级重试、DeepSeek 思维链注入。Web 面板:账号池、用量、积分构成、任务中心、模型与档位、配置、运行日志七个视图。
持久化:
auths/存账号凭据,data/存状态;可选 Redis 做多实例共享。
部署:三条路线
镜像与二进制都在官方渠道,下面三条路线按「省事程度」排序。
路线 A:GHCR 镜像(推荐)
镜像 ghcr.io/linguo2625469/workbuddy2api-panel 是公开可匿名拉取的,标签有 latest、main、1.12.0、1.12、1.11.* 等。生产环境建议钉版本号,别用 latest:
三个挂载点各有用途,别省:
挂载 | 容器内路径 | 作用 |
|---|---|---|
|
| 账号凭据(扫码/登录后写入,必须持久化) |
|
| 运行状态、用量记录 |
|
| 配置文件,改完重启容器生效 |
坑点:挂载单个文件时,宿主机上的
config.json必须先存在(所以命令第一步是cp config.example.json config.json)。如果文件不存在,Docker 会自动创建一个同名目录挂进去,程序读配置直接失败,而且报错信息不太直观。
镜像内部做了这些事:多阶段构建(golang:1.23-alpine → alpine:3.20),编译出 wb2api、signin_bin、login、credit 四个二进制,以 app(uid 10001)非 root 运行,HEALTHCHECK 打的是 /healthz,入口是 /app/wb2api -config /app/config.json。
路线 B:docker compose 自建
想自己改代码或换个构建方式,仓库根目录带了 Dockerfile 和 docker-compose.yml:
compose 文件里已经预设了几件事:user: "${PUID:-10001}:${PGID:-10001}"(挂载目录属主不对时,用环境变量把 uid/gid 对齐宿主机)、TZ=Asia/Shanghai、端口 7863:7863,以及 ./auths、./data、./config.json 三个挂载。
路线 C:Release 二进制裸跑
不想装 Docker,直接下二进制。v1.12.0 的 Release 资产一共 6 个:
Linux / macOS 包解压出来是 wb2api 主程序 + config.example.json + README.md;Windows 包解压出来是 wb2api.exe + config.example.json + README.md,双击即可用,配置写在同目录的 config.json 里。
下载后先校验,checksums.txt 里给了全部资产的 sha256:
我在 NAS 上就是这么跑的(实测 linux-amd64 包 sha256 为 857f1254d62b5368823add2af5e94f2755cd5a256df93dca6acb2ff24e7fa10a,与官方 digest 一致)。想让它常驻,用 systemd 或者 nohup 都行。
反向代理与安全
面板和 API 共用 7863 端口,程序自身不带鉴权之外的用户体系,所以:
别直接把 7863 暴露到公网。要远程访问就套 Nginx/Caddy 加 HTTPS,并在反代层加一层 Basic Auth 或 IP 白名单;
API 侧务必在配置里设
api_key,客户端带Authorization: Bearer <key>调用;auths/目录里是账号凭据,备份和迁移时注意别泄露。
添加账号
启动之后,面板里点添加账号,按提示扫码或走登录流程;成功后凭据会写进 auths/,账号立刻进入池子。多账号重复这个步骤即可,池子里的号越多,抗限流能力越强(建议至少 2~3 个,够轮转)。
CLI 层面,包里还带了三个独立二进制,方便脚本化:
二进制 | 作用 |
|---|---|
| 登录 / 添加账号 |
| 手动执行签到 |
| 查询积分 |
仓库 scripts/ 下另有几个 Python 探测脚本(probe_active.py、probe_max_tokens.py、task_*.py),用于排查上游接口行为,不是运行必需。
验证跑通
看健康检查:
账号池空的时候返回 HTTP 503,体里带清楚的状态:
加了账号之后(我这边实测 7 个号)会变成 total / healthy 有值、realm_servable 标记 CN 与 Global 两侧是否可用。
再看模型列表和一次真实调用:
客户端接入就是标准 OpenAI 套路:Base URL 填 http://<主机>:7863/v1,API Key 填配置里的 api_key,模型从 /v1/models 里挑。
Web 面板七个视图
面板是它相比同类项目最实在的加分项,全部状态都摊在页面上:
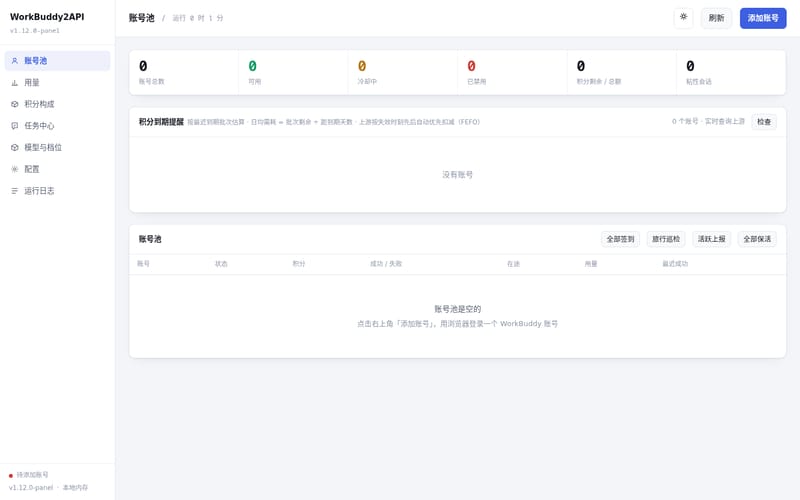
账号池:每个号的积分、健康状态、冷却剩余时间、最近使用时间,一眼看出哪个号在摸鱼。
用量:按模型/账号维度的调用量与 token 统计。
积分构成:积分从哪来(签到、任务、充值),判断账号还有多少可挖。
任务中心:五类定时任务的下次执行时间与最近结果。
模型与档位:当前探测到的模型目录及其档位/能力。
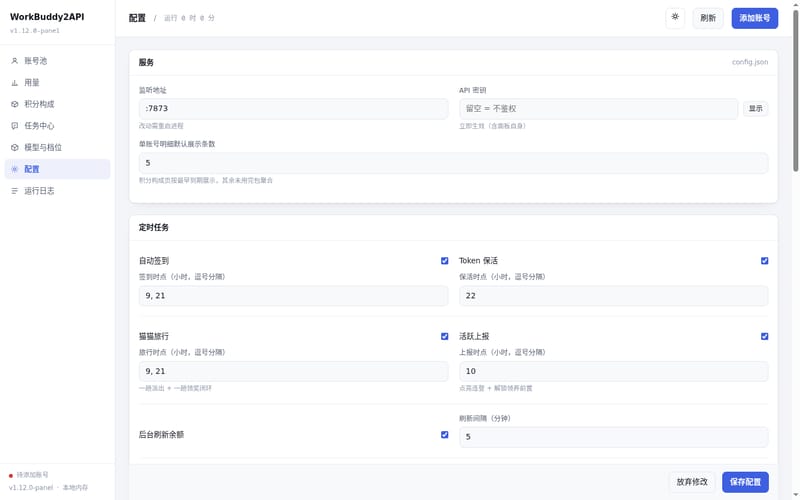
配置:图形化改配置,改完即生效(
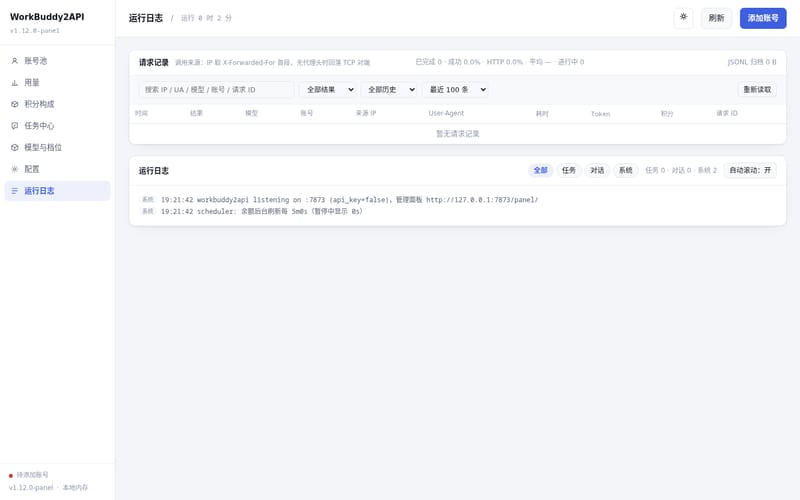
livecfg会热加载)。运行日志:带筛选的运行日志,排错主要看这里。
面板右上角显示的是 v1.12.0-panel,跟 Release tag 对应。
账号池调度:限流了怎么办
这是整个项目的核心逻辑,理解了它就知道为什么有些号会「消失」一阵子。
选号:从可用池里按权重随机,权重由「积分是否快过期」(prefer_expiring,默认开启,expiring_soon_hours 默认 168 小时)和成本分层共同决定;同时只保留 Top-5 候选再随机,避免大量请求同时砸向同一个号(防惊群)。
错误分类与冷却,不同错误处理完全不同:
上游错误 | 处理 |
|---|---|
| 软冷却,600s 起按指数退避,上限 |
| 固定 60s |
| 硬冷却,直接锁到次日 04:00 |
会话失效 | 连续 3 次才禁用账号(避免误判) |
连续失败 | 达 |
并发限制:单账号 max_inflight 默认 3,全局 max_inflight_global 默认 2。
会话粘性:同一个 conversation_id 在 TTL 30 分钟内会绑定同一个账号,多轮对话不会中途换号导致上下文错乱。
积分保护:credit_floor 默认 100,低于这个值的账号不再接新请求,留给保活和任务用。
定时任务
五类任务各自独立排程,时区跟着 TZ 走:
任务 | 默认时间 | 说明 |
|---|---|---|
签到 | 09:00 / 21:00 | 末尾会跑连登管家 |
活跃上报 | 10:00 | |
猫猫旅行 | 09:00 / 21:00 | |
token 保活 | 22:00 | |
夜猫子 | 23:00 | |
成长任务 |
| 自动执行可自动完成的成长任务 |
余额刷新 | 每 5 分钟 | 后台刷新账号积分 |
成长任务一键完成是省事最多的部分:18 个成长任务里能自动做完 17 个,唯一不能自动的是 Expert_Philanthropy(需要真实捐款)。新账号把能做的都做完,大约能拿到 +1950 credits 和 +78 能量——对白嫖党来说这是最实际的一笔收入。
配置要点与几个坑
配置是单文件 JSON,config.example.json 里每一项都带注释式说明。几个关键项:
三个容易踩的点:
`prompt.mode` 的实际默认值是 `passthrough`(代码里和
config.example.json里都是),也就是客户端传什么提示词就原样转发。想用面板里配置的系统提示词,得显式改成custom;想保留客户端提示词再追加一段,用append。出站 UA 默认是官方的三段式:
WorkBuddy/<客户端版本> WorkBuddy/<客户端版本> CLI/<CLI 版本>,内置默认值对齐官方 5.5.4 分发包与内置 CLI 2.137.1。个别上游端点对 UA 极其敏感——比如模型目录接口,用 IDE 形态的 UA 和 CLI 形态的 UA 拿到的模型集合完全不同(实测:IDE UA 14 条含o4-mini但没有 deepseek 系列;CLI UA 22 条含deepseek-v4.1-flash但没有o4-mini),所以程序对 CN / Global 两侧走了不同的多路探测再合并。不要为了「更像官方」随手改这个值,改坏了会出现「模型列表突然少一半」这种诡异现象。配置文件挂载/属主:Docker 场景下
auths、data目录属主不对会写不进去,用 compose 的PUID/PGID对齐,或者chown成 10001。
常见问题
启动后 `/healthz` 返回 503? 池子里没有可用账号。先去面板添加账号,或者检查 auths/ 是否挂载正确、凭据是否已失效。
客户端报 401? 配置里设了 api_key,但客户端没带 Authorization: Bearer,或者 key 不一致。
某个模型突然调用失败? 看面板「模型与档位」和「运行日志」:可能是该模型在当前账号档位下不可用,也可能账号正好在冷却期。
请求偶尔变慢? 账号池在换号重试,或者触发了熔断后的重试;面板「运行日志」里能看到具体是哪个号、什么错误。
数据要不要备份? 要。auths/(凭据)+ data/(状态)+ config.json 三件套打包带走,迁移即恢复。
使用声明
本项目以 MIT 协议开源,仅供个人学习与自用。请勿用于商业售卖、二次分发或加壳转卖。
使用前请阅读并遵守腾讯 CodeBuddy / WorkBuddy 的服务条款与账号使用规范,账号风险自负。
涉及自动化调用上游接口的行为,是否合规由使用者自行判断;本文只做技术记录,不构成任何授权或鼓励。
参考
项目仓库:<https://github.com/linguo2625469/workbuddy2api-panel>
当前 Release:<https://github.com/linguo2625469/workbuddy2api-panel/releases/tag/v1.12.0>
容器镜像:
ghcr.io/linguo2625469/workbuddy2api-panel